¿Puede la IA minar bitcoin mejor? Lo que hemos probado y lo que sí se optimiza
Nuestra red neuronal no ve señal en SHA-256 a partir de 9 rondas, y eso no prueba que sea imposible. Dónde hay mejoras reales: chips, firmware y energía.
Por Marc Mauri · · Hechos revisados el 3 de noviembre de 2026 · 9 min de lectura · 28 fuentes

Índice de esta página
Lo esencial. No hay ninguna forma demostrada en público de que una IA adivine qué intento ganará un bloque. En nuestra prueba, una red neuronal sencilla deja de acertar mejor que el azar a las 9 rondas de las 64 de SHA-256, pero eso mide a esa red, no a la función: otro modelo aún acierta un bit a 9 rondas, y un test clásico sin IA ve estructura a 10. Las mejoras reales están en otro sitio: chips, ajuste por chip, energía y trucos como AsicBoost, y duran poco, porque si las adopta toda la red, la dificultad las absorbe.
A 3 de noviembre de 2026, ganar un bloque de Bitcoin exige de media unos 6,4 × 10²³ intentos. Sale de multiplicar la dificultad de 148,36 billones por 2³². Si una IA pudiera descartar de antemano aunque fuera una parte de esos intentos, ahorraría una fortuna en electricidad. Por eso la idea vuelve una y otra vez. Hemos ido a comprobarla.
Qué tendría que hacer una IA para «minar mejor»
Minar consiste en cambiar un campo de la cabecera del bloque, de 80 bytes, y calcular su hash hasta que el resultado quede por debajo de un objetivo. El hash es SHA-256 aplicado dos veces, y cada pasada tiene 64 rondas de mezcla. Ese campo es el nonce, un número que no significa nada.
La IA tendría que ver una relación entre el nonce y el resultado, pero SHA-256 está diseñada para que esa relación no se note. Lo medimos con la cabecera del bloque 974.323: cambiamos un solo bit del nonce en 200.000 casos y contamos los bits que cambian en el hash final.
Dato: cambian de media 128 bits de 256, con una desviación típica de 8 bits (lo que daría lanzar 256 monedas al aire). Con las 64 rondas, este test no encuentra ninguna pista en la salida.
Nuestra prueba: una red neuronal contra SHA-256
Para saber dónde se rompe el aprendizaje, recortamos las rondas en una sola pasada de SHA-256, la del bloque que contiene el nonce. Solo cambiamos el nonce, el caso más fácil para el modelo. Usamos una red de dos capas ocultas (512 y 256 neuronas), con 300.000 ejemplos para aprender y 50.000 para examinar. Contamos los bits de salida que predice mejor que el azar, con un margen de 3,9 desviaciones.
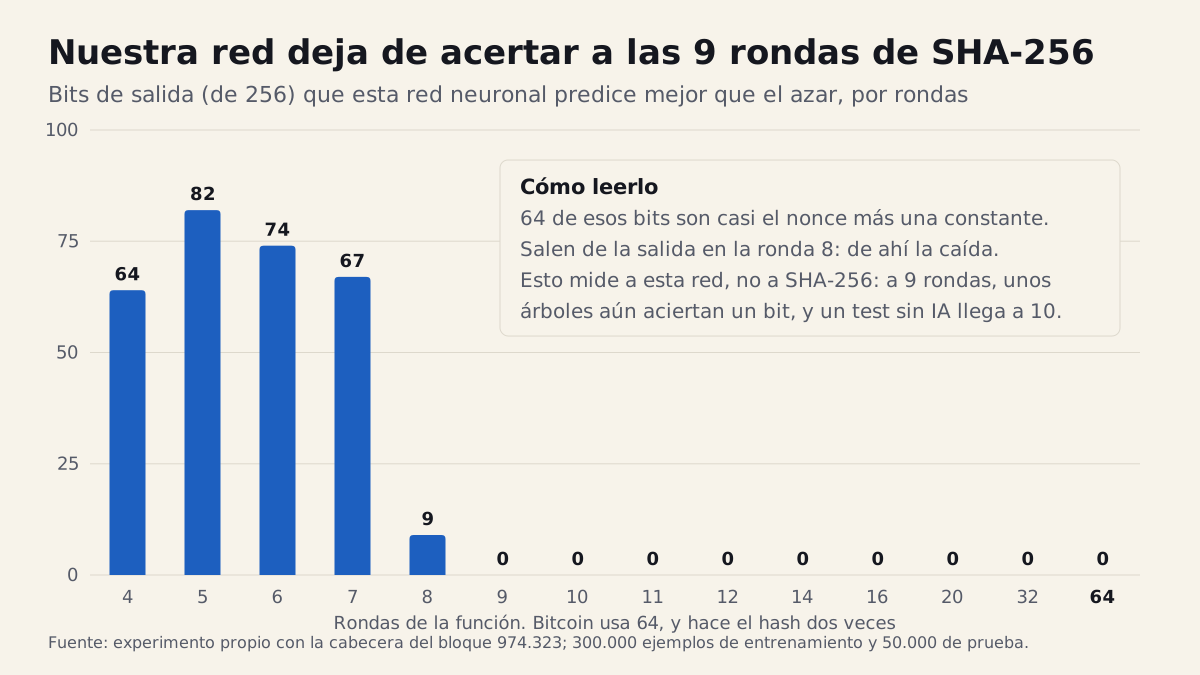
Las columnas engañan si se leen deprisa. El nonce entra en la cuarta ronda, y 64 de esos bits son poco más que el nonce sumado a una constante. SHA-256 los va pasando de registro en registro hasta que salen de la salida en la ronda 8, y eso explica casi toda la caída. Lo demás que aprende la red es poco: de 3 a 18 bits de la ronda siguiente. A 9 rondas, el acierto medio es del 50,00%.
Cuidado con la conclusión. Esas 9 rondas miden a nuestra red, no a SHA-256. Una red mayor, otra arquitectura o más datos podrían llegar más lejos. Lo comprobamos con un test clásico, sin IA: cambiamos cada bit del nonce en 100.000 casos y buscamos bits de salida que no cambien la mitad de las veces. A 9 rondas aparecen en 1.205 de las 8.192 combinaciones, y a 10, en 241. A partir de 11, este test sencillo ya no ve nada, y eso tampoco prueba que no haya nada.
Otro modelo también pasa el listón. Unos árboles de decisión, entrenados bit a bit con 600.000 ejemplos, predicen un bit a 9 rondas: aciertan el 50,65% en 2 millones de nonces nuevos, 18 desviaciones por encima del azar. Es muy poco, pero es real, y nuestra red no lo veía.
Luego repetimos con el proceso real, el doble SHA-256 completo. Pedimos un objetivo mucho más fácil, que los seis primeros bits del hash fueran cero, cosa que ocurre en uno de cada 64 intentos, y entrenamos dos modelos con 2 millones de casos. Después les pedimos que ordenaran un millón de nonces nuevos, de más a menos prometedor.
| Probando solo el mejor… | Ganadores que deberían salir por azar | Red neuronal | Árboles de decisión |
|---|---|---|---|
| 1% | 1% | 1,03% | 1,11% |
| 10% | 10% | 9,93% | 10,05% |
| 50% | 50% | 50,24% | 49,69% |
El error típico es de unos 0,08 puntos en la primera fila y 0,4 en la última, así que todo cabe en el azar. Aun así, esto no demuestra que ningún modelo pueda lograrlo, solo que estos dos, con estos datos y cambiando solo el nonce, no lo han logrado. Encaja con lo que se espera de SHA-256, pero no lo prueba.
El código, para repetirlo
El primer fichero reproduce el hash real del bloque, …8e66a2, y los vectores de prueba del NIST. El segundo es una implementación escrita aparte, y cada recorte de rondas coincide con ella.
sha_exp.py · 141 líneas · Descargar#!/usr/bin/env python3
"""Experimento: ¿aprende un modelo a predecir la salida de SHA-256 según el número de rondas?
Usa la cabecera real del bloque 974.323 y solo cambia el nonce (el caso más favorable al modelo).
Uso: sha_exp.py a 4,5,6,7,8,9,10,11,12,14,16,20,32,64 | sha_exp.py b | sha_exp.py c
Límites conocidos, comprobados en sha_exp_verif.py:
- 'a' recorta solo la compresión del bloque que contiene el nonce, sin la segunda pasada de SHA-256.Ver el código completoOcultar el código
#!/usr/bin/env python3
"""Experimento: ¿aprende un modelo a predecir la salida de SHA-256 según el número de rondas?
Usa la cabecera real del bloque 974.323 y solo cambia el nonce (el caso más favorable al modelo).

Uso: sha_exp.py a 4,5,6,7,8,9,10,11,12,14,16,20,32,64 | sha_exp.py b | sha_exp.py c

Límites conocidos, comprobados en sha_exp_verif.py:
- 'a' recorta solo la compresión del bloque que contiene el nonce, sin la segunda pasada de SHA-256.
- 'a' mide a esta red, no a SHA-256: unos árboles por bit aciertan h6 a 9 rondas (50,645%, 18 desviaciones)
y un test clásico de diferencias sin IA aún ve estructura a 10 rondas.
- Los nonces se sortean con repetición: el 0,016% de la prueba de 'a' y el 0,043% de la de 'b' están
también en entrenamiento. No se ha quitado para conservar las cifras; favorecería al modelo y es
demasiado poco para mover los resultados."""
import sys, json, hashlib, time
import numpy as np
from sklearn.neural_network import MLPClassifier
from sklearn.ensemble import HistGradientBoostingClassifier
K = np.array([
0x428a2f98,0x71374491,0xb5c0fbcf,0xe9b5dba5,0x3956c25b,0x59f111f1,0x923f82a4,0xab1c5ed5,0xd807aa98,0x12835b01,0x243185be,0x550c7dc3,0x72be5d74,0x80deb1fe,0x9bdc06a7,0xc19bf174,
0xe49b69c1,0xefbe4786,0x0fc19dc6,0x240ca1cc,0x2de92c6f,0x4a7484aa,0x5cb0a9dc,0x76f988da,0x983e5152,0xa831c66d,0xb00327c8,0xbf597fc7,0xc6e00bf3,0xd5a79147,0x06ca6351,0x14292967,
0x27b70a85,0x2e1b2138,0x4d2c6dfc,0x53380d13,0x650a7354,0x766a0abb,0x81c2c92e,0x92722c85,0xa2bfe8a1,0xa81a664b,0xc24b8b70,0xc76c51a3,0xd192e819,0xd6990624,0xf40e3585,0x106aa070,
0x19a4c116,0x1e376c08,0x2748774c,0x34b0bcb5,0x391c0cb3,0x4ed8aa4a,0x5b9cca4f,0x682e6ff3,0x748f82ee,0x78a5636f,0x84c87814,0x8cc70208,0x90befffa,0xa4506ceb,0xbef9a3f7,0xc67178f2],dtype=np.uint32)
IV = np.array([0x6a09e667,0xbb67ae85,0x3c6ef372,0xa54ff53a,0x510e527f,0x9b05688c,0x1f83d9ab,0x5be0cd19],dtype=np.uint32)
def rr(x,n): return (x>>np.uint32(n))|(x<<np.uint32(32-n))
def compress(state, W16, rounds=64, feedforward=True):
"""state: 8 arrays uint32 o escalares; W16: lista de 16 arrays uint32."""
n = max(np.size(w) for w in W16)
W = [np.broadcast_to(np.asarray(w,dtype=np.uint32),(n,)).copy() for w in W16]
for t in range(16,64):
s0 = rr(W[t-15],7)^rr(W[t-15],18)^(W[t-15]>>np.uint32(3))
s1 = rr(W[t-2],17)^rr(W[t-2],19)^(W[t-2]>>np.uint32(10))
W.append(W[t-16]+s0+W[t-7]+s1)
a,b,c,d,e,f,g,h = [np.broadcast_to(np.asarray(s,dtype=np.uint32),(n,)).copy() for s in state]
for t in range(rounds):
S1 = rr(e,6)^rr(e,11)^rr(e,25); ch=(e&f)^(~e&g)
t1 = h+S1+ch+K[t]+W[t]
S0 = rr(a,2)^rr(a,13)^rr(a,22); mj=(a&b)^(a&c)^(b&c)
t2 = S0+mj
h,g,f,e,d,c,b,a = g,f,e,d+t1,c,b,a,t1+t2
out=[a,b,c,d,e,f,g,h]
if feedforward: out=[np.asarray(s,dtype=np.uint32)+o for s,o in zip(state,out)]
return out
HDR = bytes.fromhex("000001208fb06bd1c96469b9dde6d35cb5a1184c78207f66ce2c01000000000000000000d250e41c5debe5619ced21d356eb155ee2cc3c0d989bdda7a0a77e78a4cff6bbe02de96aace50117806bc8f6")
def be(b): return int.from_bytes(b,'big')
W0 = [np.uint32(be(HDR[i:i+4])) for i in range(0,64,4)]
MID = compress(IV, W0)
MID = [np.uint32(m[0]) for m in MID]
TAIL = [np.uint32(be(HDR[64+i:64+i+4])) for i in range(0,12,4)]
def bswap(x): return ((x&0xff)<<np.uint32(24))|((x&0xff00)<<np.uint32(8))|((x>>np.uint32(8))&0xff00)|(x>>np.uint32(24))
def block2(nonce_le, rounds=64):
W=TAIL+[bswap(nonce_le),np.uint32(0x80000000)]+[np.uint32(0)]*10+[np.uint32(640)]
return compress(MID,W,rounds)
def dsha(nonce_le):
o=block2(nonce_le)
W=o+[np.uint32(0x80000000)]+[np.uint32(0)]*6+[np.uint32(256)]
return compress(IV,W)
# Comprobación contra hashlib y contra el hash real del bloque
n=np.array([int.from_bytes(HDR[76:80],'little')],dtype=np.uint32)
h=dsha(n); dig=b''.join(int(x[0]).to_bytes(4,'big') for x in h)
assert dig==hashlib.sha256(hashlib.sha256(HDR).digest()).digest(); print('hash real del bloque:',dig[::-1].hex())
def bits(x, nb=32): return ((x[:,None]>>np.arange(nb,dtype=np.uint32))&1).astype(np.float32)
rng=np.random.default_rng(974323)
class Red:
"""Perceptrón de dos capas ocultas (512 y 256) con ReLU, salida logística por bit y Adam. Solo numpy."""
def __init__(s,ni,no,sem=1):
r=np.random.default_rng(sem);s.W=[];t=[ni,512,256,no]
for a,b in zip(t,t[1:]):
s.W+=[(r.normal(0,np.sqrt(2/a),(a,b))).astype(np.float32),np.zeros(b,dtype=np.float32)]
s.m=[np.zeros_like(w) for w in s.W];s.v=[np.zeros_like(w) for w in s.W];s.t=0
def adelante(s,X):
h1=np.maximum(X@s.W[0]+s.W[1],0);h2=np.maximum(h1@s.W[2]+s.W[3],0);return h1,h2,h2@s.W[4]+s.W[5]
def paso(s,X,Y,lr=1e-3):
h1,h2,o=s.adelante(X);p=1/(1+np.exp(-np.clip(o,-30,30)));e=(p-Y)/Y.shape[1]/X.shape[0]
g4=h2.T@e;g5=e.sum(0);d2=e@s.W[4].T;m2=h2>0;d2=d2*m2
g2=h1.T@d2;g3=d2.sum(0);d1=(d2@s.W[2].T)*(h1>0);g0=X.T@d1;g1=d1.sum(0)
s.t+=1
for i,g in enumerate((g0,g1,g2,g3,g4,g5)):
s.m[i]=.9*s.m[i]+.1*g;s.v[i]=.999*s.v[i]+.001*g*g
s.W[i]-=lr*(s.m[i]/(1-.9**s.t))/(np.sqrt(s.v[i]/(1-.999**s.t))+1e-8)
def fit(s,X,Y,ep=25,lote=512):
r=np.random.default_rng(7)
for _ in range(ep):
o=r.permutation(len(X))
for k in range(0,len(X)-lote+1,lote):
b=o[k:k+lote];s.paso(X[b],Y[b])
return s
def expA(rounds_list,ntr=300000,nte=50000,out='expA.json'):
res=[]
for r in rounds_list:
t0=time.time()
nonce=rng.integers(0,2**32,ntr+nte,dtype=np.uint32)
o=block2(nonce,rounds=r)
Y=np.concatenate([bits(x) for x in o],axis=1)
X=bits(nonce)*2-1
frac=Y[:ntr].mean(0);var=(frac>0.02)&(frac<0.98)
Yv=Y[:,var]
m=Red(32,int(var.sum())).fit(X[:ntr],Yv[:ntr])
p=m.adelante(X[ntr:])[2]>0
acc=(p==(Yv[ntr:]>.5)).mean(0)
tr=((m.adelante(X[:20000])[2]>0)==(Yv[:20000]>.5)).mean(0)
umbral=3.9*0.5/np.sqrt(nte)
rec=dict(rounds=r,bits_variables=int(var.sum()),acc_media=float(acc.mean()),acc_max=float(acc.max()),acc_min=float(acc.min()),acc_train=float(tr.mean()),
bits_con_senal=int((acc>.5+umbral).sum()),bits_por_debajo=int((acc<.5-umbral).sum()),umbral=float(umbral),seg=time.time()-t0)
print(rec,flush=True); res.append(rec); json.dump(res,open(out,'w'),indent=1)
def expB(zero_bits=6,ntr=2000000,nte=1000000):
nonce=rng.integers(0,2**32,ntr+nte,dtype=np.uint32)
h=dsha(nonce)
# El hash se lee al revés: los ceros de cabeza son los últimos bytes del digest
top=bswap(h[7])
y=(top>>np.uint32(32-zero_bits))==0
X=bits(nonce)
print('positivos',y.mean(),1/2**zero_bits)
out={}
g=HistGradientBoostingClassifier(max_iter=300,learning_rate=0.1,max_leaf_nodes=63,random_state=1)
g.fit(X[:ntr],y[:ntr]); s=g.predict_proba(X[ntr:])[:,1]
m=MLPClassifier((512,256),batch_size=1024,max_iter=15,random_state=1,tol=1e-6,n_iter_no_change=5)
m.fit(X[:ntr]*2-1,y[:ntr]); s2=m.predict_proba(X[ntr:]*2-1)[:,1]
for name,sc in (('gbdt',s),('mlp',s2)):
idx=np.argsort(-sc)
yt=y[ntr:]
for frac in (0.01,0.1,0.3,0.5):
k=int(frac*nte); cap=yt[idx[:k]].sum()/yt.sum()
se=np.sqrt(frac*(1-frac)/yt.sum())
out[f'{name}_{frac}']=dict(captura=float(cap),esperado=frac,error_tipico=float(se))
print(name,{k:v for k,v in out.items() if k.startswith(name)},flush=True)
json.dump(out,open('expB.json','w'),indent=1)
def avalanche(n=200000):
nonce=rng.integers(0,2**32,n,dtype=np.uint32)
b=rng.integers(0,32,n,dtype=np.uint32)
h1=dsha(nonce); h2=dsha(nonce^(np.uint32(1)<<b))
d=np.zeros(n,dtype=np.int32)
for x,y in zip(h1,h2):
d+=np.unpackbits(np.frombuffer((x^y).tobytes(),dtype=np.uint8)).reshape(n,32).sum(1).astype(np.int32)
print('avalancha media',d.mean(),'desv',d.std(),'min',d.min(),'max',d.max())
json.dump(dict(media=float(d.mean()),desv=float(d.std()),min=int(d.min()),max=int(d.max())),open('avalancha.json','w'))
if __name__=='__main__':
c=sys.argv[1]
if c=='a': expA([int(x) for x in sys.argv[2].split(',')])
if c=='b': expB()
if c=='c': avalanche()sha_exp_verif.py · 163 líneas · Descargar#!/usr/bin/env python3
"""Comprobaciones del experimento sha_exp.py, hechas por el verificador el 3 de noviembre de 2026.
Uso (con numpy y scikit-learn, desde un directorio de trabajo fuera del repositorio):
python -I sha_exp_verif.py vectores # NIST, hash real y recorte de rondas contra otra implementación
python -I sha_exp_verif.py solape # nonces repetidos entre entrenamiento y prueba
python -I sha_exp_verif.py base # línea base de clase mayoritaria y señal por registro
python -I sha_exp_verif.py diferencias # test clásico sin IA: cambiar un bit del nonceVer el código completoOcultar el código
#!/usr/bin/env python3
"""Comprobaciones del experimento sha_exp.py, hechas por el verificador el 3 de noviembre de 2026.

Uso (con numpy y scikit-learn, desde un directorio de trabajo fuera del repositorio):
    python -I sha_exp_verif.py vectores     # NIST, hash real y recorte de rondas contra otra implementación
    python -I sha_exp_verif.py solape       # nonces repetidos entre entrenamiento y prueba
    python -I sha_exp_verif.py base         # línea base de clase mayoritaria y señal por registro
    python -I sha_exp_verif.py diferencias  # test clásico sin IA: cambiar un bit del nonce
python -I sha_exp_verif.py dedicado # red y árboles solo con los registros menos mezclados (d y h)
Los registros se nombran a..h como en FIPS 180-4. Tras r rondas, d = a(r-3) y h = e(r-3) más una
constante, de modo que un bit de la ronda r-3 sigue visible en la salida de la ronda r.
"""
import hashlib, importlib.util, json, os, struct, sys, time
import numpy as np
sys.dont_write_bytecode = True # -I ignora PYTHONDONTWRITEBYTECODE; así no se deja __pycache__ en el repositorio
_p = os.path.join(os.path.dirname(os.path.abspath(__file__)), 'sha_exp.py')
_s = importlib.util.spec_from_file_location('sha_exp', _p)
sx = importlib.util.module_from_spec(_s)
_s.loader.exec_module(sx)
K = [int(k) for k in sx.K]
IV = [int(k) for k in sx.IV]
M = 2**32 - 1
REG = 'abcdefgh'
def rr(x, n):
return ((x >> n) | (x << (32 - n))) & M
def comp(st, blk, r=64):
"""Compresión de SHA-256 en Python puro, sin numpy, con r rondas."""
W = list(struct.unpack('>16I', blk))
for t in range(16, 64):
W.append((W[t-16] + (rr(W[t-15], 7) ^ rr(W[t-15], 18) ^ (W[t-15] >> 3)) + W[t-7]
+ (rr(W[t-2], 17) ^ rr(W[t-2], 19) ^ (W[t-2] >> 10))) & M)
a, b, c, d, e, f, g, h = st
for t in range(r):
t1 = (h + (rr(e, 6) ^ rr(e, 11) ^ rr(e, 25)) + ((e & f) ^ ((~e) & M & g)) + K[t] + W[t]) & M
t2 = ((rr(a, 2) ^ rr(a, 13) ^ rr(a, 22)) + ((a & b) ^ (a & c) ^ (b & c))) & M
h, g, f, e, d, c, b, a = g, f, e, (d + t1) & M, c, b, a, (t1 + t2) & M
return [(x + y) & M for x, y in zip(st, [a, b, c, d, e, f, g, h])]
def pad(m):
n = len(m)
m = m + b'\x80'
m += b'\0' * ((56 - len(m)) % 64)
return m + struct.pack('>Q', n * 8)
def vectores():
casos = ((b'abc', 'ba7816bf8f01cfea414140de5dae2223b00361a396177a9cb410ff61f20015ad'),
(b'', 'e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855'),
(b'abcdbcdecdefdefgefghfghighijhijkijkljklmklmnlmnomnopnopq',
'248d6a61d20638b8e5c026930c3e6039a33ce45964ff2167f6ecedd419db06c1'))
for msg, esperado in casos:
p = pad(msg)
st = IV
st2 = [np.uint32(x) for x in IV]
for i in range(0, len(p), 64):
st = comp(st, p[i:i+64])
o = sx.compress(st2, [np.uint32(x) for x in struct.unpack('>16I', p[i:i+64])])
st2 = [np.uint32(x[0]) for x in o]
d1 = b''.join(x.to_bytes(4, 'big') for x in st).hex()
d2 = b''.join(int(x).to_bytes(4, 'big') for x in st2).hex()
assert d1 == d2 == esperado == hashlib.sha256(msg).hexdigest()
print('vectores FIPS 180-4: correctos con las dos implementaciones')
mid = comp(IV, sx.HDR[:64])
assert [int(x) for x in sx.MID] == mid
ns = np.random.default_rng(1).integers(0, 2**32, 200, dtype=np.uint32)
for r in range(1, 65):
o = sx.block2(ns, rounds=r)
for i, n in enumerate(ns):
blk = sx.HDR[64:76] + int(n).to_bytes(4, 'little') + b'\x80' + b'\0' * 39 + struct.pack('>Q', 640)
assert [int(x[i]) for x in o] == comp(mid, blk, r), (r, i)
print('recorte de rondas 1 a 64: coincide con la implementación en Python puro en 200 nonces')
for r in range(1, 6):
o = sx.block2(ns, rounds=r)
print(' ronda', r, 'registros que dependen del nonce:', [REG[i] for i, x in enumerate(o) if np.unique(x).size > 1])
def solape():
g = np.random.default_rng(974323)
for ntr, nte, nom in ((300000, 50000, 'A'), (2000000, 1000000, 'B')):
x = g.integers(0, 2**32, ntr + nte, dtype=np.uint32)
c = int(np.isin(x[ntr:], x[:ntr]).sum())
print(f'experimento {nom}: {c} de {nte} nonces de prueba están también en entrenamiento ({c/nte:.5%})')
def base():
rng = np.random.default_rng(974323)
ntr, nte = 300000, 50000
um = 3.9 * .5 / np.sqrt(nte)
for r in (4, 5, 6, 7, 8, 9, 10):
nonce = rng.integers(0, 2**32, ntr + nte, dtype=np.uint32)
o = sx.block2(nonce, rounds=r)
Y = np.concatenate([sx.bits(x) for x in o], axis=1)
X = sx.bits(nonce) * 2 - 1
frac = Y[:ntr].mean(0)
var = (frac > .02) & (frac < .98)
idx = np.where(var)[0]
m = sx.Red(32, int(var.sum())).fit(X[:ntr], Y[:ntr][:, var])
acc = ((m.adelante(X[ntr:])[2] > 0) == (Y[ntr:][:, var] > .5)).mean(0)
maj = np.maximum(frac[var], 1 - frac[var])
sen = acc > .5 + um
print(dict(r=r, variables=int(var.sum()), sobre_50=int(sen.sum()), sobre_mayoritaria=int((acc > maj + um).sum()),
mayoritaria_max=round(float(maj.max()), 4), por_registro={REG[i]: int(sen[(idx // 32) == i].sum()) for i in range(8)}), flush=True)
def diferencias(n=100000):
base_n = np.random.default_rng(7).integers(0, 2**32, n, dtype=np.uint32)
res = []
for r in list(range(4, 25)) + [28, 32, 48, 64]:
o = sx.block2(base_n, rounds=r)
dmax, celdas = 0, 0
for b in range(32):
o2 = sx.block2(base_n ^ (np.uint32(1) << np.uint32(b)), rounds=r)
p = np.concatenate([sx.bits(x ^ y) for x, y in zip(o, o2)], axis=1).mean(0)
d = np.abs(p - .5)
dmax = max(dmax, float(d.max()))
celdas += int((d > 5 * .5 / np.sqrt(n)).sum())
rec = dict(rondas=r, desvio_max=round(dmax, 4), celdas_con_senal=celdas, de=32 * 256)
res.append(rec)
print(rec, flush=True)
json.dump(res, open('diferencias.json', 'w'), indent=1)
def dedicado():
from sklearn.ensemble import HistGradientBoostingClassifier as G
rng = np.random.default_rng(20261103)
ntr, nte = 1500000, 200000
um = 3.9 * .5 / np.sqrt(nte)
for r in (9, 10):
nonce = rng.integers(0, 2**32, ntr + nte, dtype=np.uint32)
o = sx.block2(nonce, rounds=r)
Y = np.concatenate([sx.bits(o[3]), sx.bits(o[7])], axis=1)
X = sx.bits(nonce) * 2 - 1
m = sx.Red(32, 64, sem=3).fit(X[:ntr], Y[:ntr], ep=12, lote=512)
acc = ((m.adelante(X[ntr:])[2] > 0) == (Y[ntr:] > .5)).mean(0)
print(dict(r=r, modelo='red, 64 salidas, 1,5 M', con_senal=int((acc > .5 + um).sum()), acierto_max=round(float(acc.max()), 4)), flush=True)
acct = []
modelos = []
for j in range(64):
g = G(max_iter=150, learning_rate=.1, max_leaf_nodes=63, random_state=1).fit(X[:600000] > 0, Y[:600000, j])
acct.append(float((g.predict(X[ntr:] > 0) == Y[ntr:, j]).mean()))
modelos.append(g)
acct = np.array(acct)
j = int(acct.argmax())
nom = ('d' if j < 32 else 'h') + str(j % 32)
print(dict(r=r, modelo='árboles por bit, 600 k', con_senal=int((acct > .5 + um).sum()), mejor_bit=nom, acierto_max=round(float(acct.max()), 4)), flush=True)
# Se confirma el mejor bit con nonces nuevos, que no han servido para elegirlo
nv = np.random.default_rng(r * 1000 + 1).integers(0, 2**32, 2000000, dtype=np.uint32)
o2 = sx.block2(nv, rounds=r)
y2 = sx.bits(o2[3] if j < 32 else o2[7])[:, j % 32]
a2 = float((modelos[j].predict(sx.bits(nv) > .5) == y2).mean())
print(dict(r=r, confirmacion=nom, nonces_nuevos=len(nv), acierto=round(a2, 5), desviaciones=round((a2 - .5) / (.5 / np.sqrt(len(nv))), 1)), flush=True)
if __name__ == '__main__':
{'vectores': vectores, 'solape': solape, 'base': base, 'diferencias': diferencias, 'dedicado': dedicado}[sys.argv[1]]()Qué dice la literatura
Los trabajos serios apuntan en la misma dirección. El aprendizaje profundo sí ha servido contra cifrados con menos rondas: Gohr mejoró en 2019 los ataques contra Speck32/64 con 11 rondas, un cifrado pequeño, y Goncharov probó a invertir en parte, entre otros, SHA-256 con pocas rondas y a veces debilitada. No hemos encontrado ningún artículo revisado que haga algo así con la función completa.
Los récords clásicos también están lejos. A 3 de noviembre de 2026, lo más lejos que hemos visto son colisiones prácticas con 35 pasos y, en otro trabajo, un par real con 36 y un ataque teórico con 38, de coste 2¹⁰⁴. Antes hubo 39 pasos en un modelo más débil, y SHA-256 tiene 64. Esas cifras también enseñan que la criptografía clásica llega mucho más allá de nuestras 9 rondas. Además, una colisión son dos entradas con el mismo hash, y minar no necesita eso.
Por qué importa. Un modelo que predijera mejor que el azar con la función completa revelaría una debilidad de SHA-256, que se usa en todas partes, y sería noticia de primera página en criptografía. Es una deducción nuestra, pero sirve para valorar cualquier anuncio.
Y aunque acertara, tendría que salir a cuenta
Hay una barrera de coste que se suele olvidar. Un doble SHA-256 son unas 1.200 sumas de 32 bits, por nuestra cuenta: dos veces 64 rondas de siete sumas, más la expansión del mensaje y la suma final. Máquinas recientes gastan de 13,5 a 17,5 julios por terahash, o sea de 13,5 a 17,5 picojulios por hash.
La red pequeña de nuestra prueba hace unas 148.000 multiplicaciones para evaluar un solo nonce. Para cuando ha decidido si merece la pena probarlo, un chip ya ha calculado muchos hashes. Cualquier filtro tendría que ser ínfimo y además acertar.
Dónde sí se ganó de verdad: AsicBoost
AsicBoost es el mejor ejemplo de optimización real. No predice nada: aprovecha cómo se reparte la cabecera dentro de SHA-256 para reutilizar parte del cálculo entre intentos. Hanke lo publicó en 2016, con una mejora de alrededor del 20%. Maxwell hablaba en 2017 de hasta un 30% de energía, más probablemente un 20%. También dijo que la ingeniería inversa de un chip de un gran fabricante, al que no nombraba, había revelado una capacidad oculta para usarlo.
Hubo patentes por ambas partes: la de Hanke y Lerner y una solicitud china de Bitmain sobre una técnica parecida, que esa ficha da por rechazada en 2020.
Hoy se hace a la vista. BIP 310 define cómo negociar el cambio de bits de la versión del bloque, y BIP 320 reserva los bits del 13 al 28 para usos como este.
Dato: de los 1.020 últimos bloques, 967 usan esos bits, el 94,8%. Es un cálculo nuestro con bloques hasta el 974.323, y un indicio: la cabecera no prueba por sí sola para qué se usaron. Pero si casi todos lo hacen, ya no da ventaja frente a los demás.
El resto de la optimización real
| Palanca | Cifra pública | Quién lo dice | ¿Hay IA? |
|---|---|---|---|
| Circuito del chip | 15% menos de área y consumo con entradas fijas | Patente de Intel | No |
| Diseño a mano | Área menor, sin síntesis automática | Patente de MicroBT | No |
| Diseño de sumadores con IA | 16% menos de área a 32 bits | NVIDIA, sin relación con minería | Sí |
| Colocación de bloques con IA | Horas en vez de semanas, muy discutido | Google y sus críticos | Sí |
| Firmware por chip | De 17,5 a 15,4 J/TH en una S21 | Braiins, su mejor medida | Ajuste automático |
| Contratos de energía | 31,7 millones de dólares en un mes por reducir consumo | Riot, agosto de 2023 | No consta |
| Refrigeración | Hasta un 40% menos, en centros de Google | DeepMind, 2016 | Sí, no en minería |
El caso de NVIDIA es tentador, porque SHA-256 es sobre todo sumar a 32 bits. Pero no hemos encontrado a ningún fabricante de chips de minería que diga usarlo. La patente de MicroBT va en sentido contrario: defiende el diseño manual frente a las herramientas automáticas.
Las plantillas de bloque, es decir, elegir qué transacciones incluir, aportan muy poco hoy. En esos 1.020 bloques, las comisiones reales fueron 18,54 BTC y las que mempool.space esperaba, 19,05. Lograr esa diferencia sumaría un 0,016% al ingreso, por nuestra cuenta. Bitcoin Core 31 ha mejorado esa selección, pero el margen depende de que suban las comisiones.
Lo que se anuncia sin datos públicos
Una empresa cotizada en Londres, Quantum Blockchain Technologies, dijo en 2024 que su «oráculo de IA» mostraba capacidad predictiva en cerca del 30% de los casos. En marzo de 2026 lo portaba a una vieja Antminer S9, sin dar cifras de esa máquina y con una frase clara: «there cannot be guarantee at this stage».
En su aviso del 3 de agosto de 2026 habla de una ventaja consistente en sus periodos de prueba, sin porcentaje, y admite que aún falta trabajo antes de probarlo en vivo. No hemos encontrado ninguna prueba independiente ni datos con los que repetirla. Nuestra lectura es que hay que ver esos datos antes de creerlo.
Cuidado: las apps y webs de «minería con IA» son otra cosa. Si una promete ingresos diarios, pide que enseñe sus máquinas y los bloques que ha minado. Antes de pagar, repasa las señales en nuestra guía de estafas.
Hacia dónde va esto
Lo razonable es esperar más de lo mismo: mejores chips, más ajuste fino y energía más barata. Un estudio de 2017 tampoco veía una ventaja cercana con ordenadores cuánticos, aunque ya tiene años. El riesgo cuántico para Bitcoin lo tratamos aparte.
Cada mejora dura lo que tarda en generalizarse, porque la dificultad sube y la absorbe. El efecto más visible de la IA en la minería no está en el algoritmo: está en los contratos que convierten centros de minería en centros de datos. Si te preguntas si hay monedas donde minar con más maña sí cuenta, las hay, y lo explicamos aquí. El panorama general está en hacia dónde va la minería.
Artículo informativo, no asesoramiento financiero ni fiscal. Se ha preparado con ayuda de IA y una persona ha comprobado los hechos: así trabajamos. ¿Has visto un error? Escribe a elbitcoinblog@gmail.com.
Fuentes (28)
- Block chain, referencia del protocolo · Bitcoin Developer Documentation, consultada el 3 de noviembre de 2026
- FIPS 180-4, Secure Hash Standard · NIST, consultada el 3 de noviembre de 2026
- API de minería: dificultad y potencia estimada · mempool.space, consultada el 3 de noviembre de 2026
- API de bloques: los 1.020 últimos desde el 974.323 · mempool.space, consultada el 3 de noviembre de 2026
- Improving Attacks on Round-Reduced Speck32/64 using Deep Learning (2019) · Aron Gohr, IACR ePrint, consultada el 3 de noviembre de 2026
- Using fuzzy bits and neural networks to partially invert few rounds of some cryptographic hash functions (2019) · Sergij V. Goncharov, arXiv, consultada el 3 de noviembre de 2026
- New Records in Collision Attacks on SHA-2 (2024) · Li, Liu y Wang, IACR ePrint, consultada el 3 de noviembre de 2026
- Pushing the Limit of Memory-efficient Collision Attack Framework for SHA-2 (2026) · Li, Liu, Wang y Shi, IACR ePrint, consultada el 3 de noviembre de 2026
- Pushing Collision Attacks on SHA-2 to 39 Steps (2026) · Li, Zhang, Li, Liu, Qian y Zhu, IACR ePrint, consultada el 3 de noviembre de 2026
- AsicBoost: A Speedup for Bitcoin Mining (2016) · Timo Hanke, arXiv, consultada el 3 de noviembre de 2026
- BIP proposal: Inhibiting a covert attack on the Bitcoin POW function (05/04/2017) · Gregory Maxwell, lista bitcoin-dev (espejo de b10c), consultada el 3 de noviembre de 2026
- Patente WO2015077378A1, Block mining methods and apparatus · Google Patents, consultada el 3 de noviembre de 2026
- Patente CN105245327A, Bitmain · Google Patents, consultada el 3 de noviembre de 2026
- BIP 310: Stratum protocol extensions · Bitcoin BIPs, GitHub, consultada el 3 de noviembre de 2026
- BIP 320: nVersion bits for general purpose use · Bitcoin BIPs, GitHub, consultada el 3 de noviembre de 2026
- Patente US10142098B2, Optimized SHA-256 datapath · Google Patents, consultada el 3 de noviembre de 2026
- Patente US20230195990A1, MicroBT · Google Patents, consultada el 3 de noviembre de 2026
- PrefixRL: Optimization of Parallel Prefix Circuits using Deep Reinforcement Learning · NVIDIA, arXiv, consultada el 3 de noviembre de 2026
- How AlphaChip transformed computer chip design (26/09/2024) · Google DeepMind, consultada el 3 de noviembre de 2026
- The False Dawn: Reevaluating Google's Reinforcement Learning for Chip Macro Placement · Igor L. Markov, arXiv, consultada el 3 de noviembre de 2026
- Smarter clock speed management for Bitcoin miners (23/05/2025) · Braiins, consultada el 3 de noviembre de 2026
- Riot announces August 2023 production and operations updates · Riot Platforms, consultada el 3 de noviembre de 2026
- DeepMind AI reduces Google data centre cooling bill by 40% (20/07/2016) · Google DeepMind, consultada el 3 de noviembre de 2026
- Bitcoin Core 31.0, notas de la versión (19/04/2026) · Bitcoin Core, consultada el 3 de noviembre de 2026
- Quantum Blockchain announces Bitcoin mining Method C using AI (13/03/2024) · Proactive Investors (prensa), consultada el 3 de noviembre de 2026
- Porting AI Oracle onto an Antminer S9 (24/03/2026) · Quantum Blockchain Technologies, en Cision, consultada el 3 de noviembre de 2026
- Update on Method C AI Oracle Testing (03/08/2026) · Quantum Blockchain Technologies, en Investegate, consultada el 3 de noviembre de 2026
- Quantum attacks on Bitcoin, and how to protect against them (2017) · Aggarwal, Brennen, Lee, Santha y Tomamichel, arXiv, consultada el 3 de noviembre de 2026


